NHIを理解する | 変化するアイデンティティ、人とマシンからAIエージェントへ
アプリケーション、サービス、デバイス、AIエージェントも、人と同じようにシステムへアクセスするためのアイデンティティが必要です。これらは非人間アイデンティティ(Non-Human Identity、NHI)と呼ばれます。本記事では、アイデンティティが人間のユーザーを超えてどのように進化してきたか、そしてNHIのセキュリティが、組織による自動化やAIエージェントの安心した導入にどう役立つかを解説します。
アイデンティティの変遷
アイデンティティの始まりはコンピューターの共同利用
複数の人が同じコンピューターを使い始めたとき、システムには利用者を区別する方法が必要になりました。MITのCompatible Time-Sharing System(CTSS)は、1961年に初めて実演され、ユーザーがそれぞれのファイルと作業環境を維持しながら、コンピューティング資源を共有できるようにしました。CTSSは、パスワードを使用した最初のコンピューターシステムとして広く知られています(MIT:Fernando Corbató、CTSS、コンピューターパスワードの起源)。
これは、単にサインインするための仕組みではありませんでした。あるユーザーが別のユーザーのファイルを無条件に読めるべきではなく、一般ユーザーが管理者と同じ権限を持つべきでもありません。アイデンティティは、関連はあるものの異なる2つの機能の基盤となりました。アカウントを正当に使用できることを確認する認証と、そのアカウントが何にアクセスできるかを決める認可です。
この区別は、現在も重要です。認証に成功したからといって、無制限のアクセスを与えてよいわけではないのです。
ローカルアカウントから企業とクラウドのアイデンティティへ
組織がより多くのコンピューターを接続するにつれて、マシンごとに個別のアカウントを管理する方法は現実的ではなくなりました。ディレクトリサービスは、ユーザー、コンピューター、グループ、リソースへのアクセスを一元的に管理する場所を提供しました。Microsoft Active Directory Domain Servicesは、このアプローチのよく知られた例です(Microsoft:Active Directory Domain Servicesの概要)。
アイデンティティの一元化により、アクセス管理は従業員のライフサイクルにも組み込まれました。入社時にはアカウントを作成し、異動時には権限を変更し、退職時にはアクセスを削除する必要があります。役割を終えた後も使えるアカウントは、単なる管理上の見落としではなく、アクセスに関するリスクです。
インターネットとクラウドは、アイデンティティの範囲を社内ネットワークの外へと広げました。従業員は、メール、Webサイト、SaaSアプリケーション、クラウドプラットフォームへのアクセスを必要とするようになりました。クラウドのアイデンティティプロバイダーは、ユーザーをこれらのサービスにつなぐ役割を担いました。以前はAzure Active Directoryと呼ばれていたMicrosoft Entra IDも、このモデルに属します。Microsoft Entra IDはActive Directory Domain Servicesとは異なるものであり、同じシステムの名前を変更しただけではありません(Microsoft:Active DirectoryとMicrosoft Entra IDの比較)。
メールアドレスは、アカウントを表す身近なラベルとして使われるようになりました。しかし、ラベルだけがアイデンティティのすべてではありません。その背後には、認証情報、属性、グループへの所属、権限、アクセスポリシーがあります。アカウント名を認識することと、リクエストが正当であることを検証することは、別の作業です。
ゼロトラストがアクセスの判断に状況を取り入れた
正しいユーザー名とパスワードだけでは、状況のすべては分かりません。従業員が、見慣れないデバイス、管理対象外のノートPC、あるいは想定外の場所からサインインしているかもしれません。アカウントが有効でも、そのリクエストには追加の確認が必要な場合があります。
ゼロトラストは、ネットワーク上の場所や企業が所有しているという理由だけで自動的に信頼することを否定し、この問題に対処します。NISTのZero Trust Architectureでは、アクセスを要求する主体、デバイス、要求されたリソースを考慮したアクセス判断が示されています(NIST SP 800-207:Zero Trust Architecture)。
そのため、問いは「あなたは誰か?」から、「誰が、どのデバイスから、どのような条件でアクセスを要求しているのか?」へと広がります。既知のアカウントであることは判断材料の1つであり、リクエスト自体の評価に代わるものではありません。
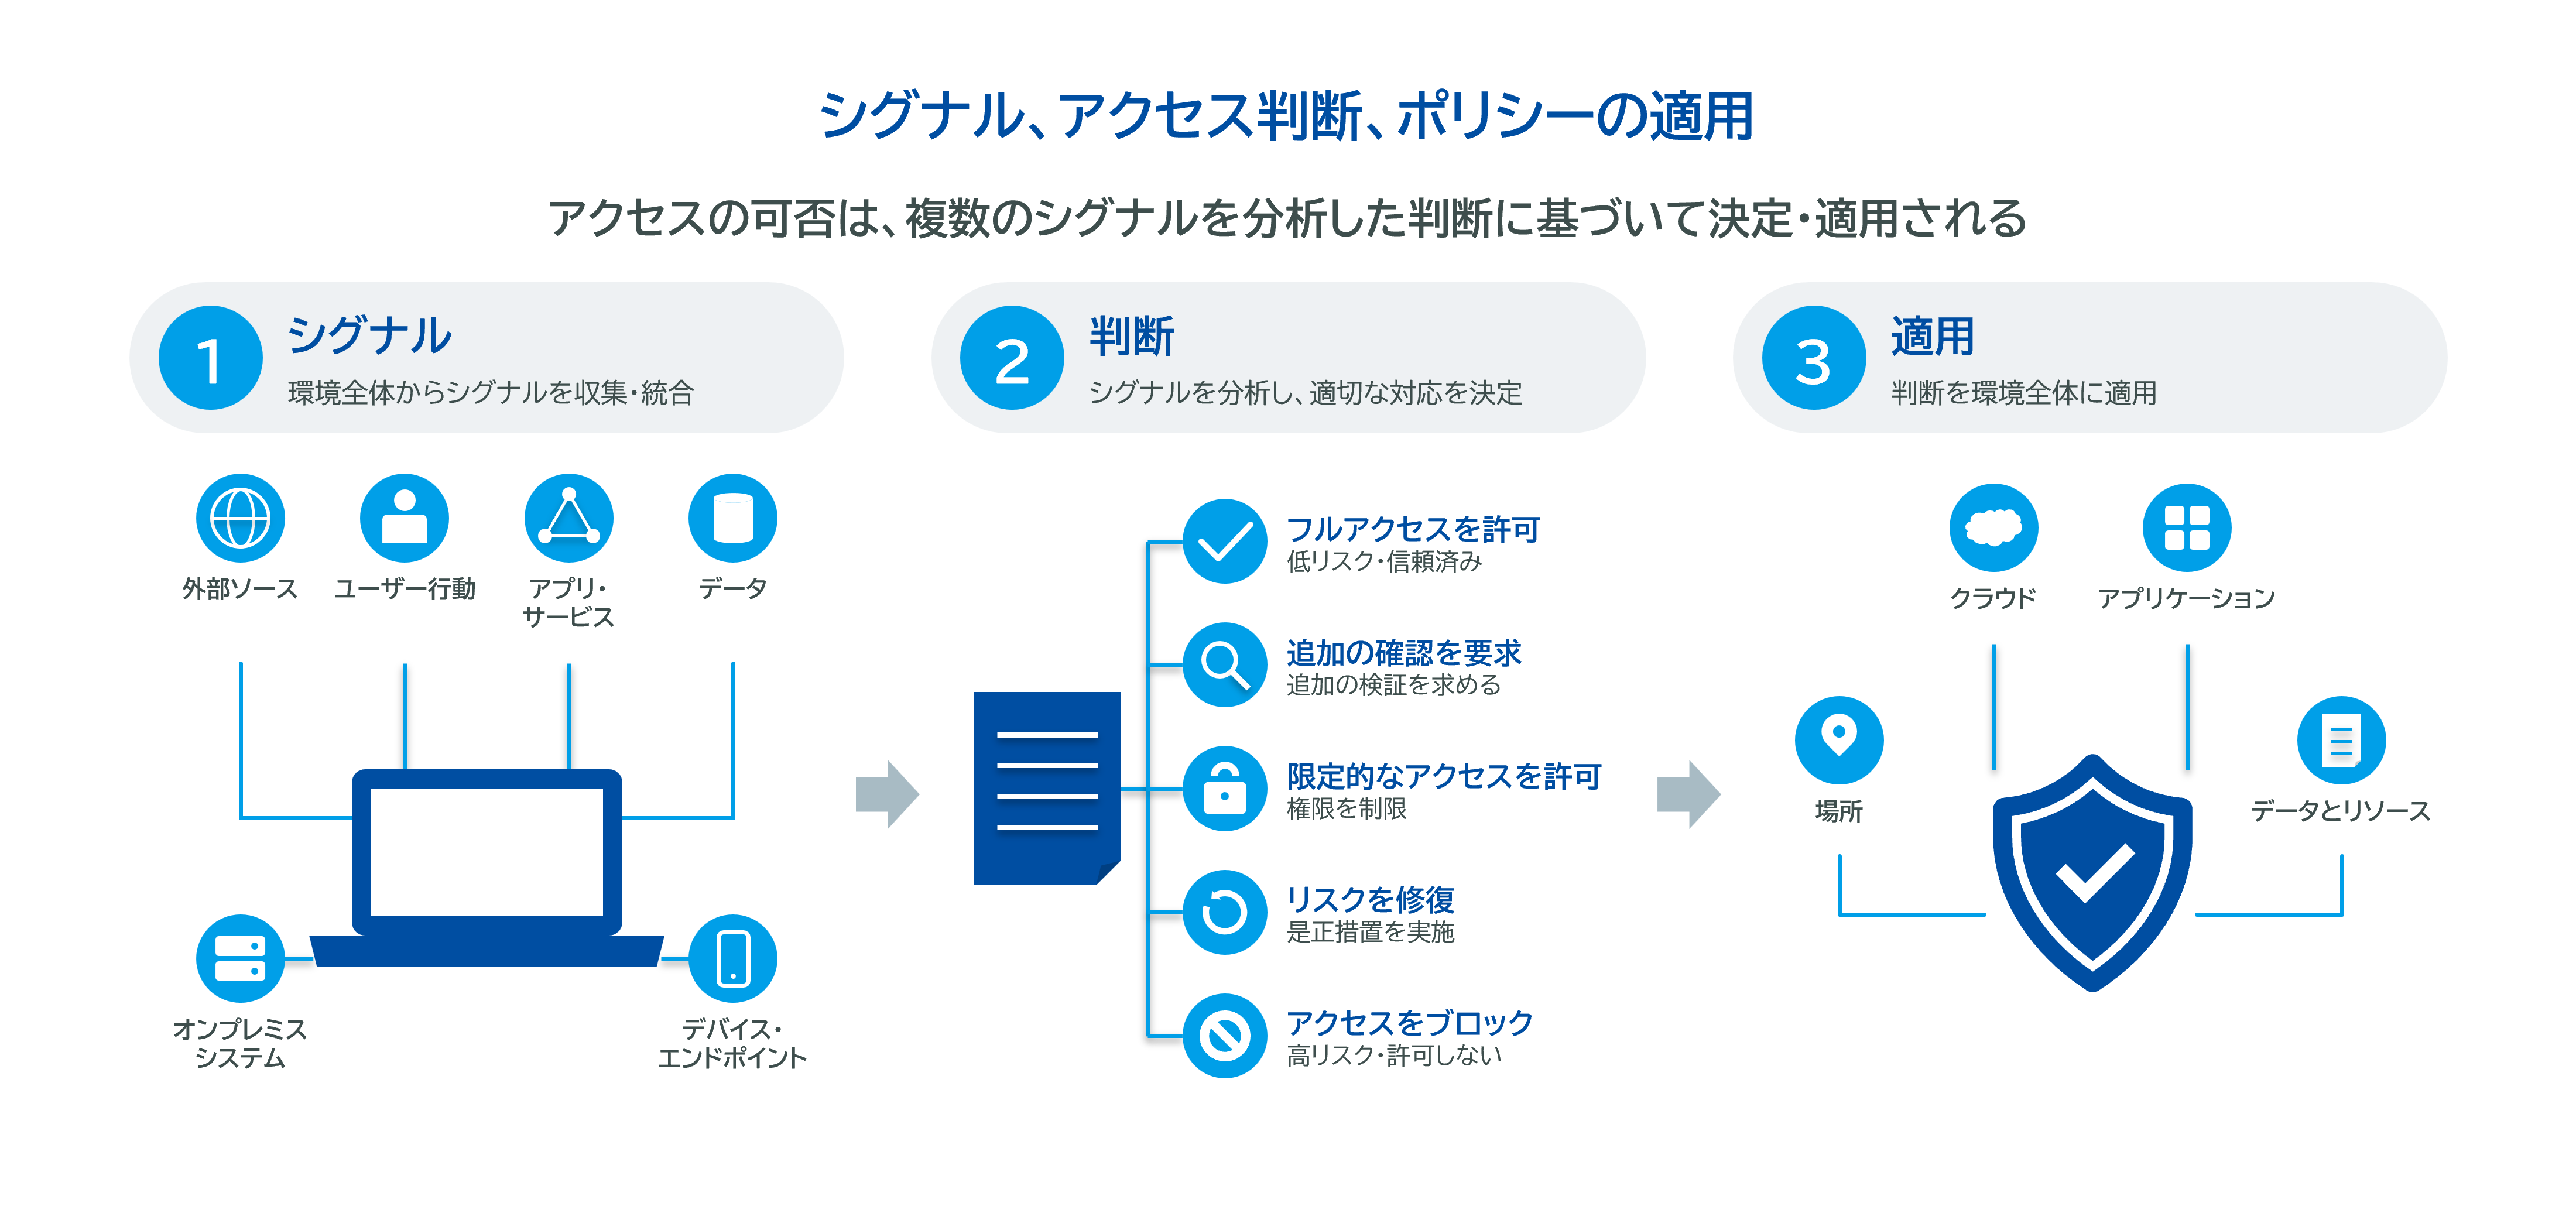
図1:シグナル、アクセス判断、ポリシーの適用
出典:Microsoft Learn:条件付きアクセスの概要。原典の概念を基に、本記事向けに作成された図です。
マシンにもアイデンティティが必要
アクセスを要求するのは、人だけではありません。デプロイパイプラインには、アプリケーションをデプロイする権限が必要です。サービスには、データベースを読み取る権限が必要です。スクリプトには、シークレットを取得する権限が必要です。ノートPCが、登録済みデバイスであることを証明する必要もあります。
これらは、非人間アイデンティティ(Non-Human Identity、NHI) の例です。デバイスアイデンティティはデバイスを表し、ワークロードアイデンティティは、アプリケーション、サービス、スクリプト、コンテナーなどのソフトウェアを表します。Microsoftは、ワークロードアイデンティティを、ソフトウェアが認証を行い、リソースにアクセスするための仕組みとして説明しています(Microsoft:ワークロードアイデンティティとは)。
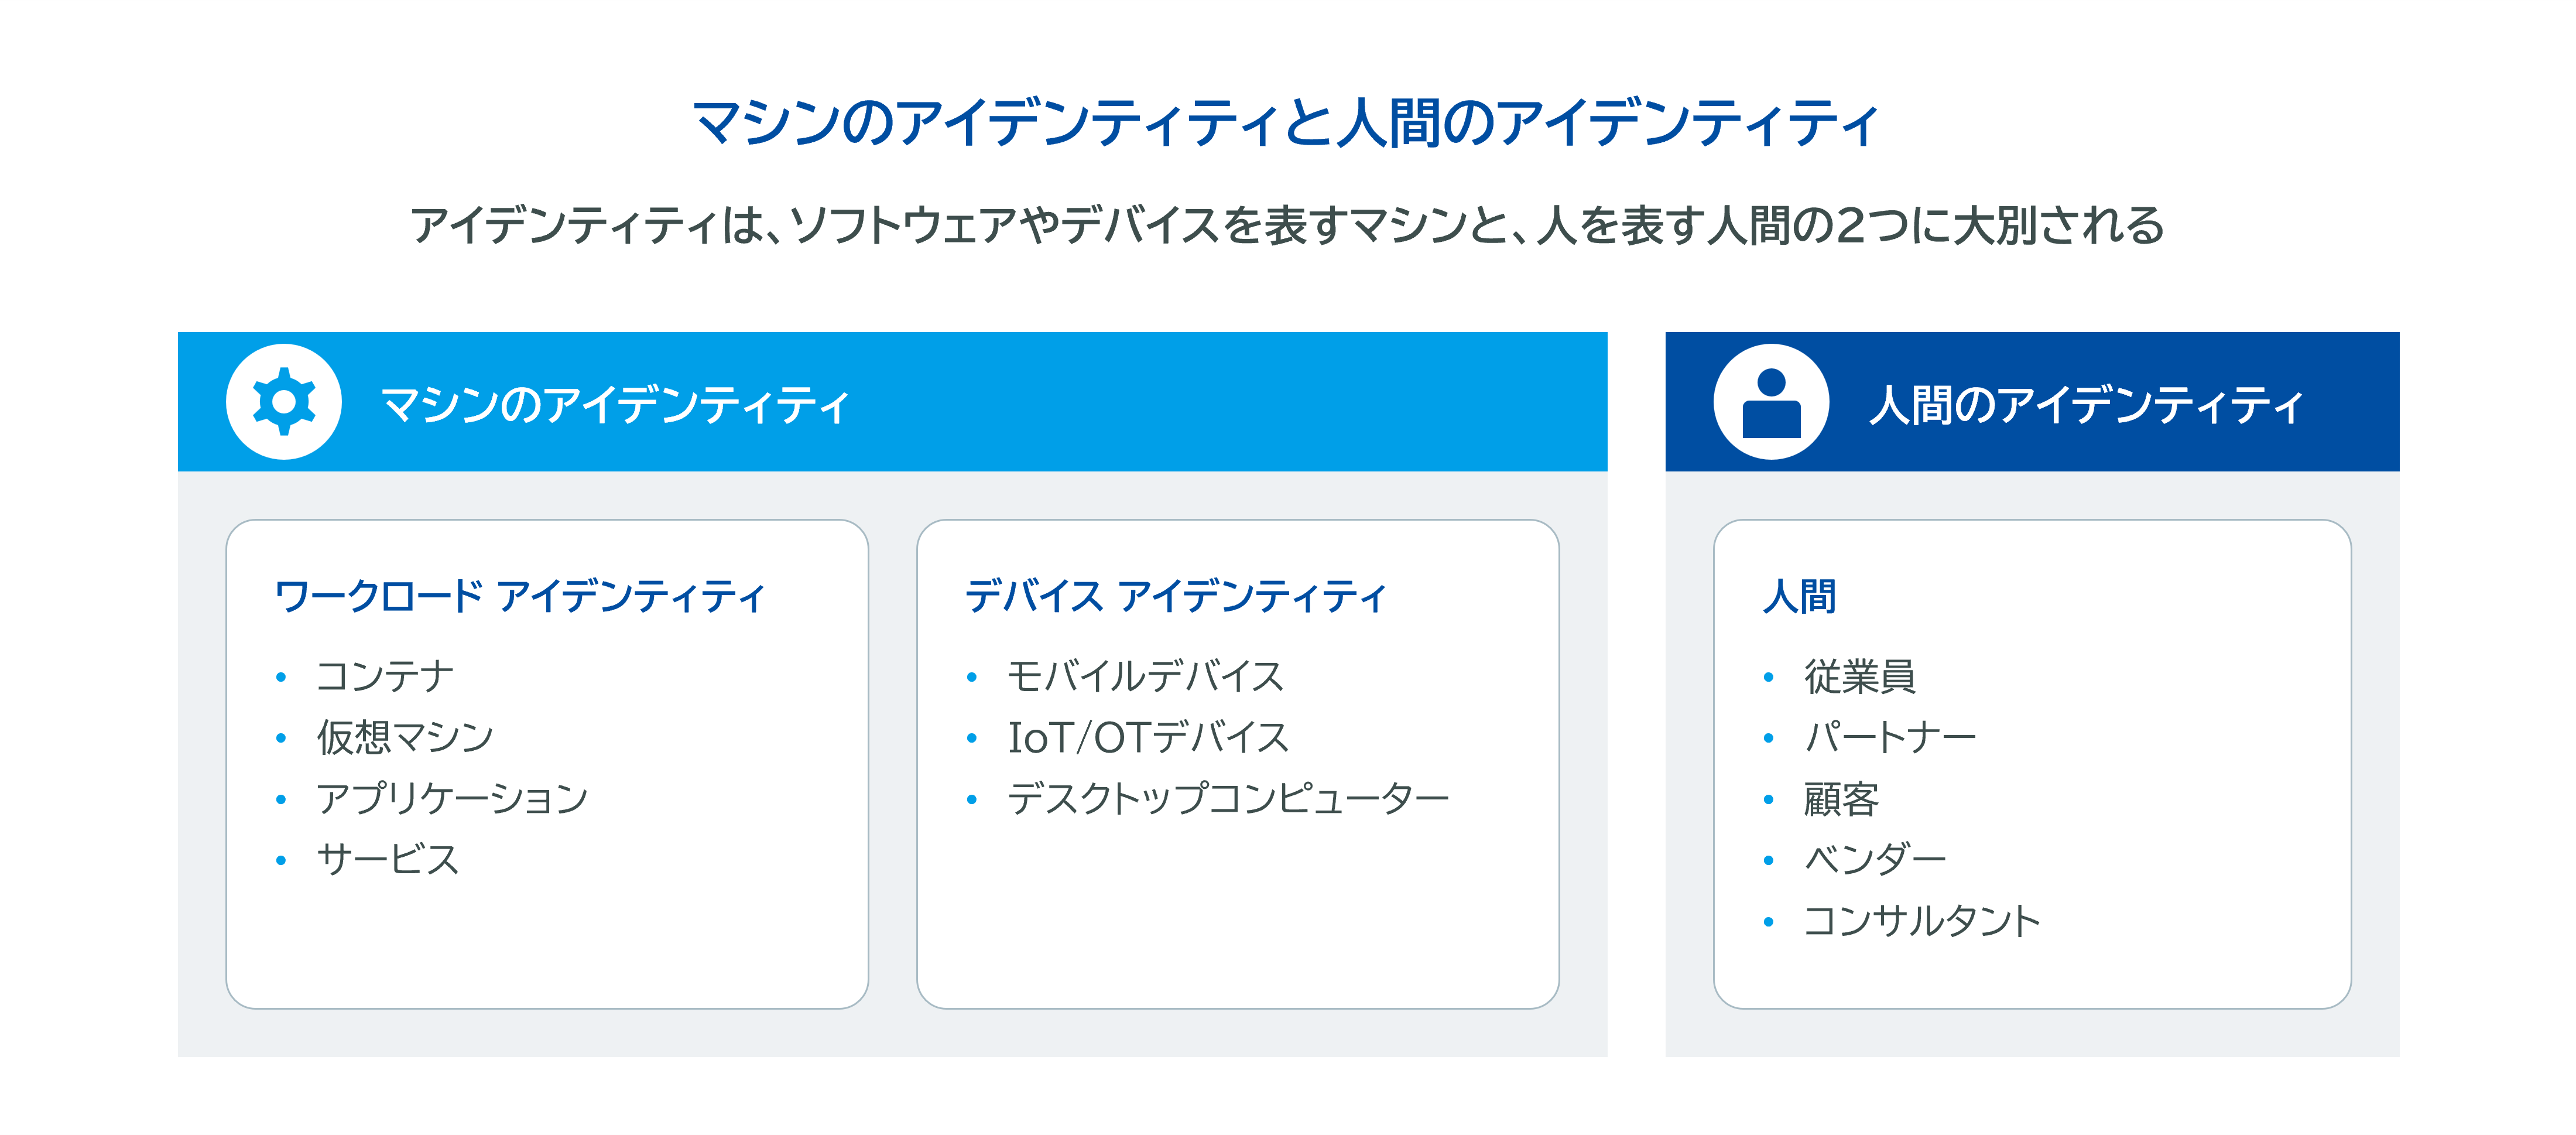
識別子だけでは、アイデンティティを証明するには不十分です。MACアドレスはネットワークインターフェイスを識別しますが、強力な認証と同等ではありません。デバイス登録では、代わりに暗号技術に基づく認証情報を利用できます。例えば、Microsoft Entraのデバイス登録では、鍵とデバイス証明書が作成されます(Microsoft:デバイス登録のしくみ)。
非人間アイデンティティ (NHI) にも、ライフサイクル管理が必要です。サービスが廃止されても、アカウントが有効なまま残ることがあります。ワークフローが忘れられても、その認証情報は使い続けられるかもしれません。従業員とは異なり、これらの主体は、アクセスレビューのきっかけとなる人事プロセスを自然に通るわけではありません。権限、認証情報、そして最終的な削除に責任を持つ人が必要です。
AIエージェント時代のアイデンティティ
AIエージェントが新たな課題をもたらす
非人間アイデンティティ (NHI) は、AIによって生まれたものではありません。サービスアカウント、アプリケーションの認証情報、証明書、自動化用のトークンは、エージェントが登場するずっと前から存在していました。エージェントが加えるのは、モデルに基づく判断を使って、ワークフロー内で実行する操作を選ぶ能力です。Microsoftのワークロードアイデンティティに関するドキュメントでも、AIエージェントは、追加のガバナンス要件を持つ独立したマシンアイデンティティの分類として扱われています。
請求書を確認し、不一致を見つけ、フォローアップを準備するよう依頼されたエージェントを考えてみましょう。設計と権限によっては、エージェントは文書を選び、ツールを呼び出し、記録を比較し、どの手順を実行するかを決めます。ユーザーは、すべての操作を指定するのではなく、目標を与えます。
ここで、責任の所在に関する問いが生まれます。エージェントが記録を変更した場合、その変更は従業員が直接行ったのでしょうか。それとも、エージェントがタスクの一環として選択したのでしょうか。すべての操作が共用の人間用アカウントに記録されると、この区別を明らかにするのは難しくなります。
問題は、権限の委任そのものが不適切だということではありません。アプリケーションがユーザーに代わって正当に操作することはあります。問題は、権限を委任したユーザーと、実際に作業を行ったエージェントの区別が失われることです。
エージェントには固有のアイデンティティと明確な制限が必要
エージェントは、ユーザーに代わって操作する場合も含め、操作を実行した主体として識別できるべきです。その権限は、作成者が持つすべての権限を自動的に引き継ぐのではなく、タスクに合ったものにする必要があります。
請求書の確認という例では、文書の読み取りとフォローアップの下書き作成は適切かもしれません。一方、支払いの承認や支払先情報の変更は、別の責任に属します。これらの操作には個別の権限が必要であり、ワークフロー上で求められる場合は、人による承認も必要です。
Microsoft Entra Agent IDは、こうした要件に対応するアイデンティティプラットフォームの一例です。Microsoftはこれを、AIエージェントのアイデンティティを認証、認可、管理、保護するためのフレームワークと説明しています。このモデルでは、技術的な管理に責任を持つ所有者(owner)と、エージェントの業務上の目的およびライフサイクルに責任を負うスポンサー(sponsor)を区別しています(Microsoft Entra Agent IDの概要、所有者、スポンサー、マネージャー)。
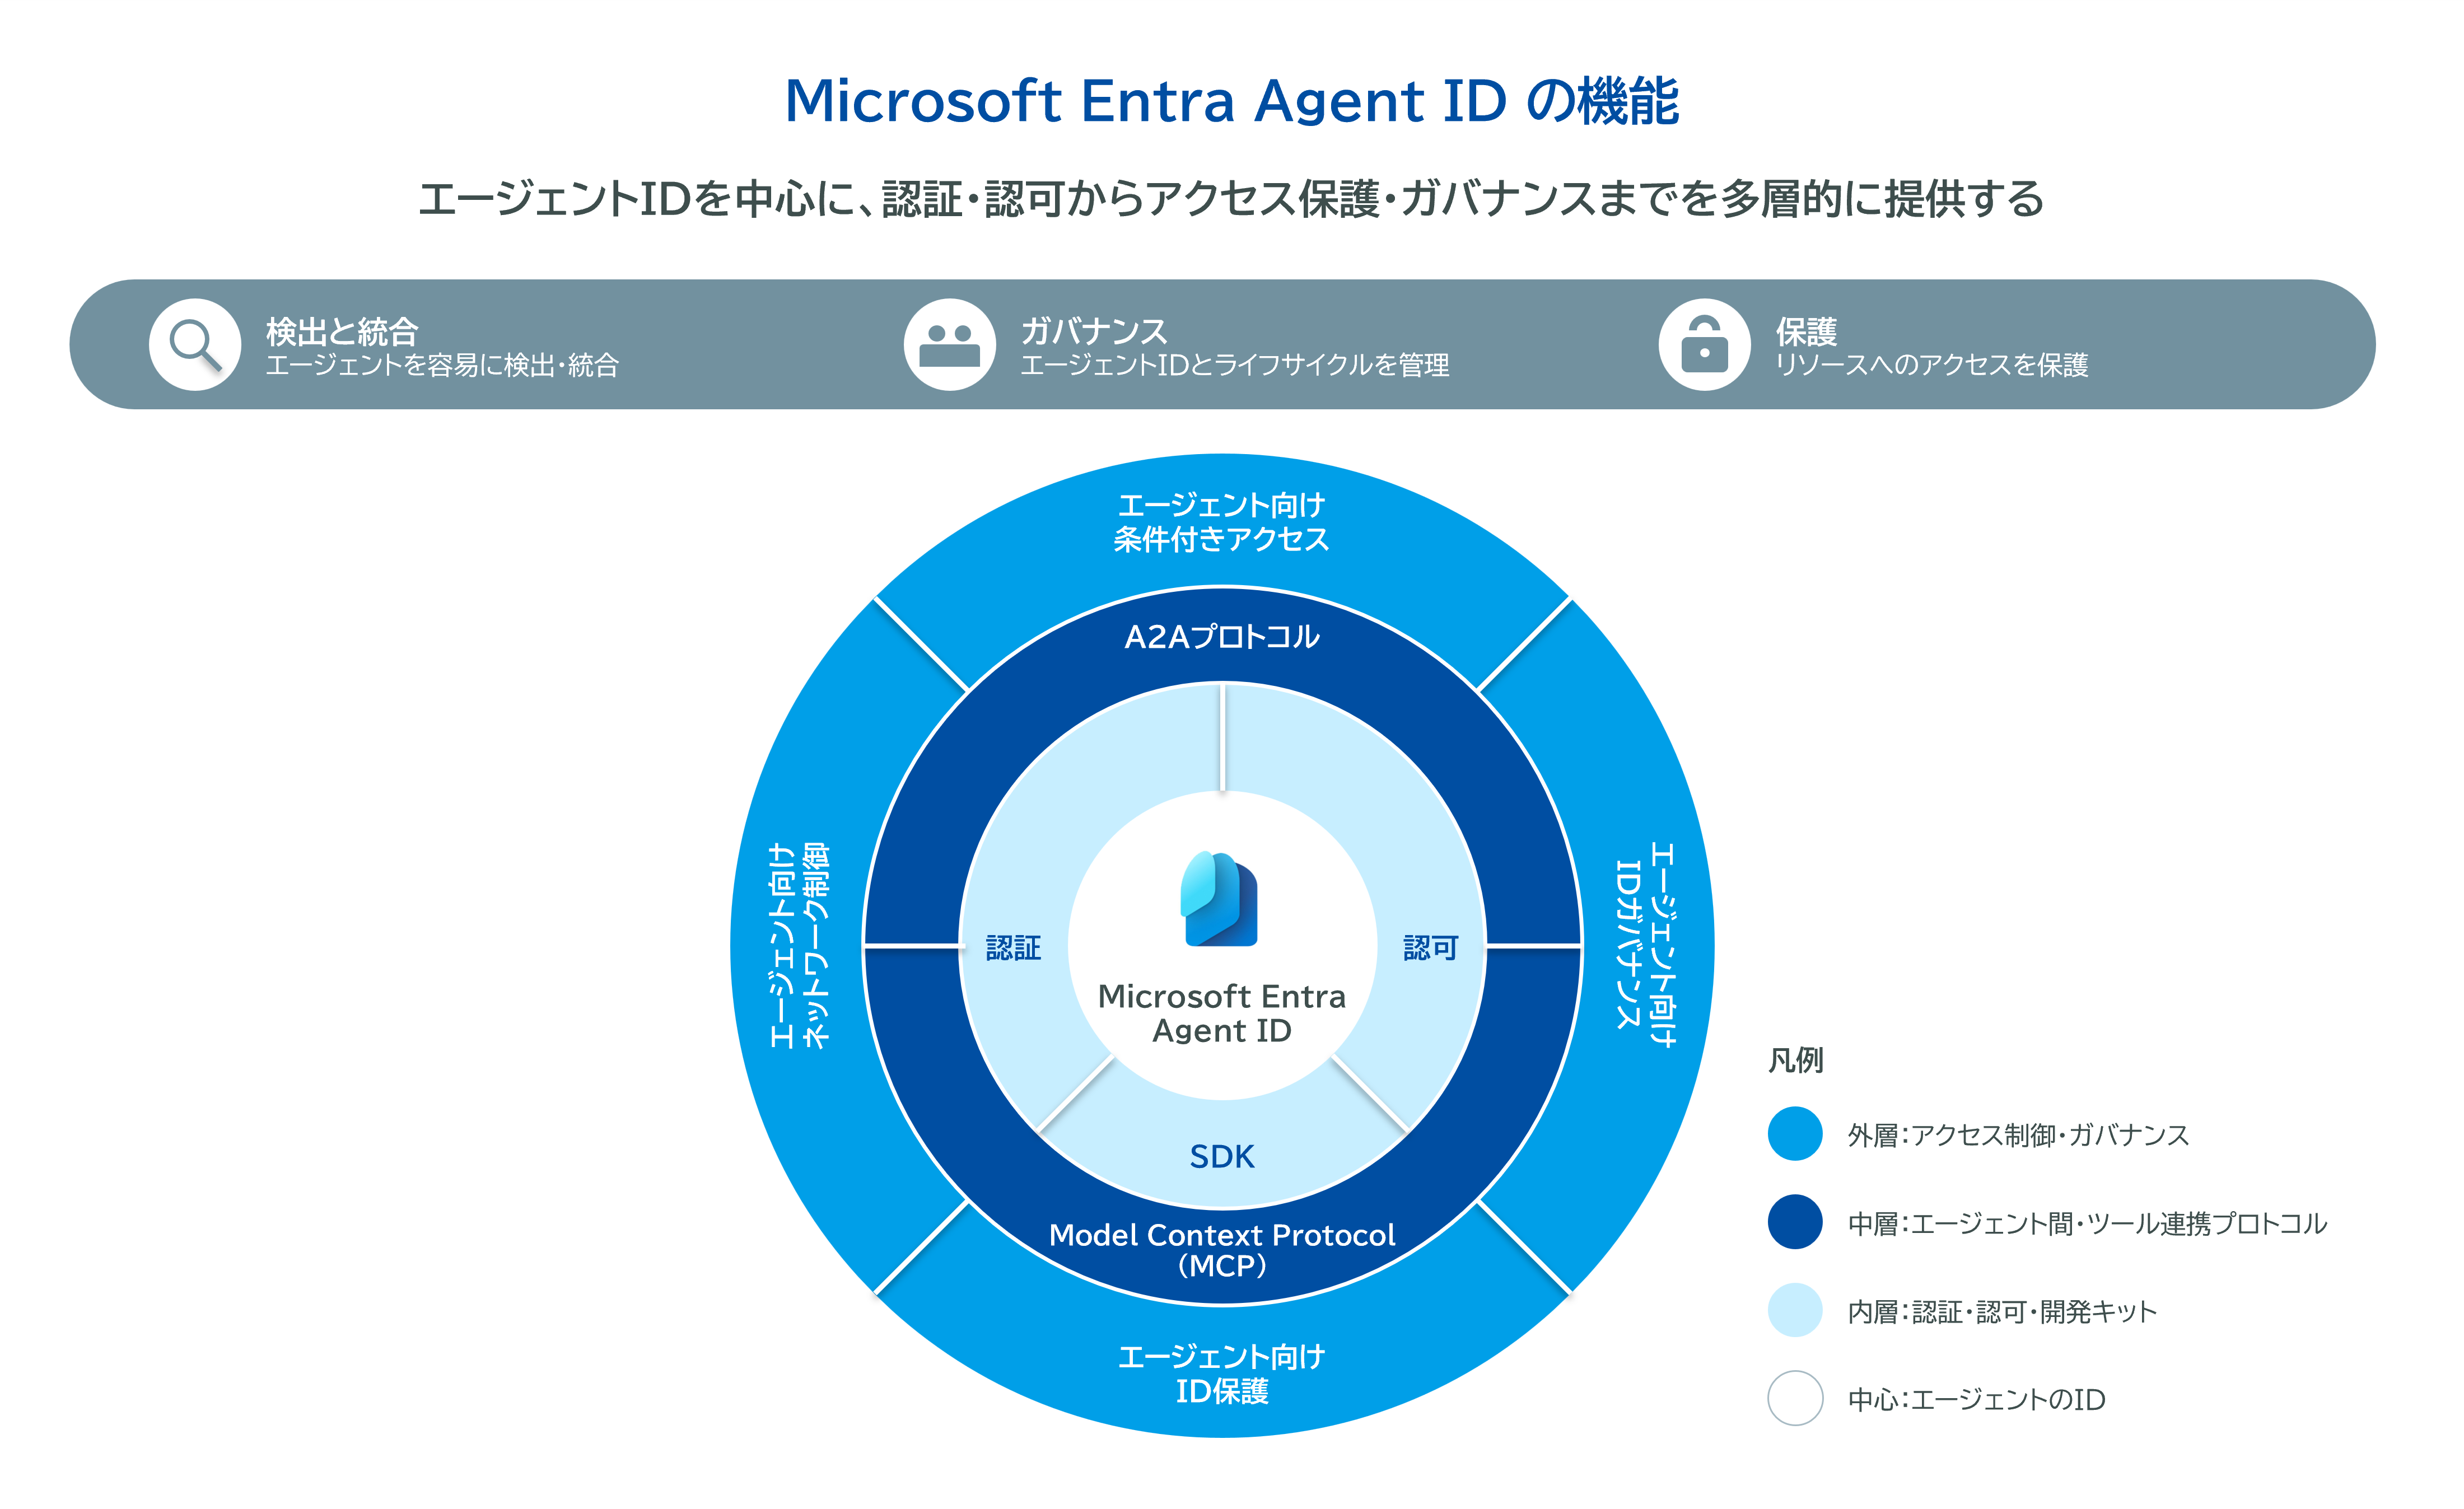
エージェントに固有のアイデンティティを与えても、人の責任がなくなるわけではありません。作業を実行する主体と、その作業の許可や監督に責任を持つ人を分けることになります。操作記録は、どのエージェントが動作し、どの権限を使い、どのユーザーがタスクを委任したのか、あるいはユーザーによる委任がなかったのかを確認できるものであるべきです。アイデンティティだけですべての判断を説明することはできません。アプリケーションやツールも、有用なログを出力する必要があります。
認証情報の保護は引き続き必要
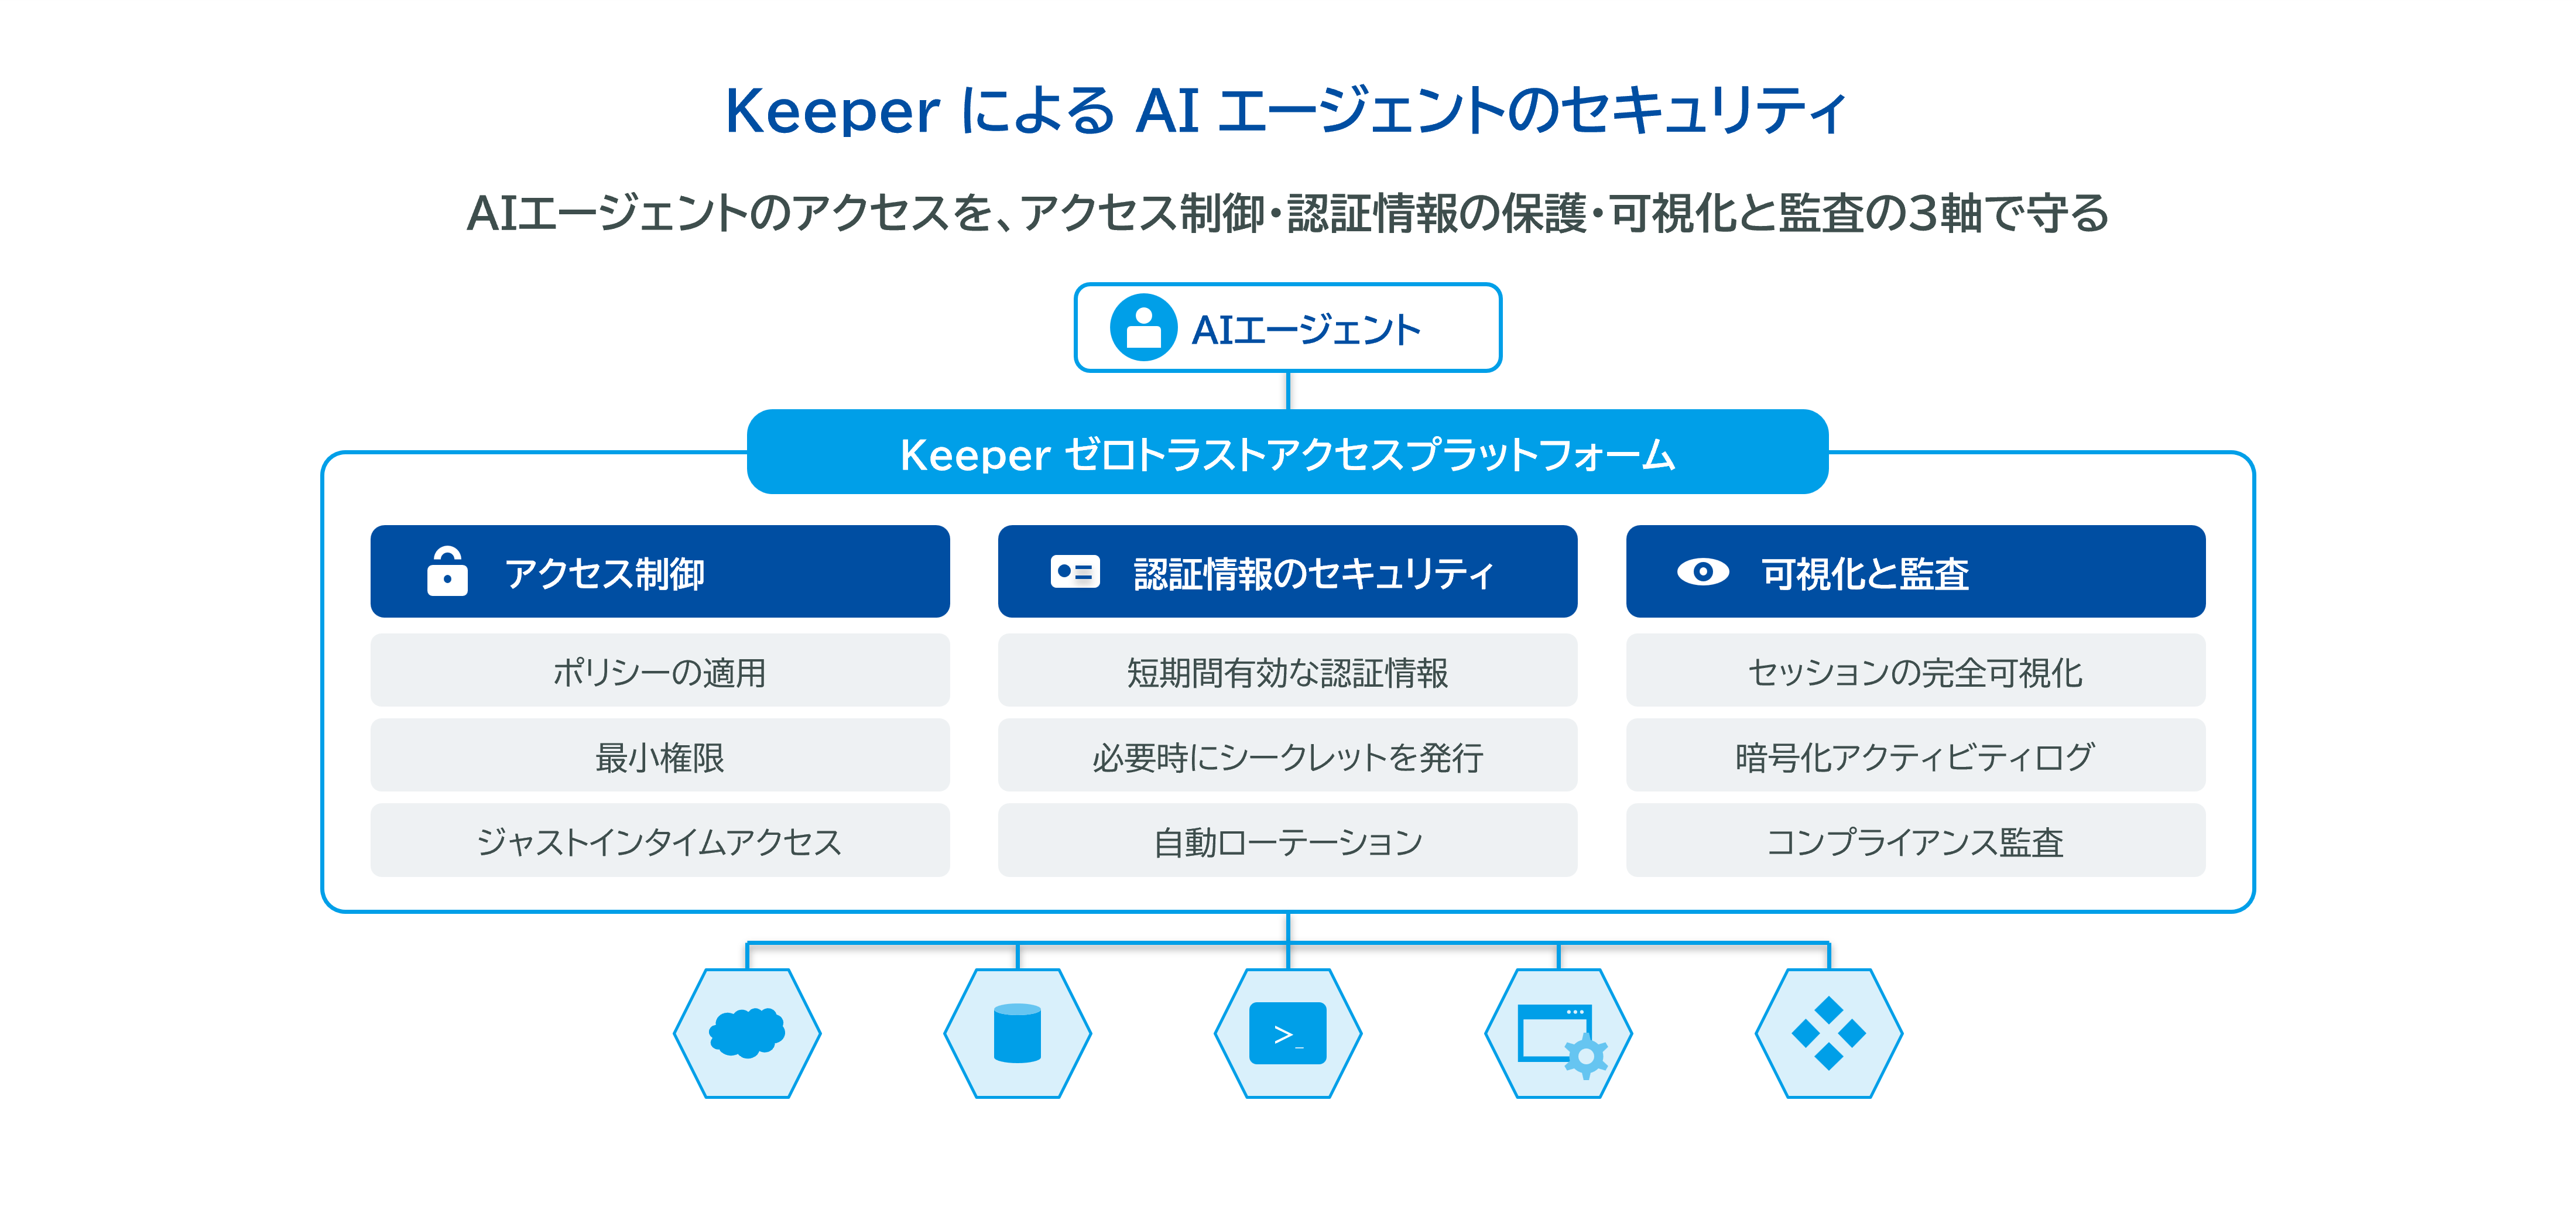
すべてのワークロードやエージェントが、シークレットの使用を避けられるわけではありません。マネージドIDやフェデレーションを使うものもあれば、パスワード、APIキー、証明書、その他の認証情報に依存するものもあります。これらの認証情報は、それによって利用できるアクセス権限と併せて保護する必要があります。
シークレット管理と特権アクセス管理のツールは、この部分の課題に対応します。Keeper Secrets Managerは、ワークロードや自動化に対して、範囲を限定したプログラム経由のシークレットアクセスを提供します。KeeperPAMは、設定に基づく認証情報のローテーションやセッションの監督など、特権アクセスの機能を追加します(Keeper Secrets Managerの概要、KeeperPAMのドキュメント)。
これらのツールは、アイデンティティプロバイダーを置き換えるものではなく、補完するものです。アイデンティティプラットフォームは、操作主体の確認とアクセスの統制を支援します。シークレット管理や特権アクセス管理のツールは、作業を実行する際に使用される認証情報と接続の保護を支援します。認証情報を保護するだけで、それに紐づく権限が適切になるわけではありません。
アイデンティティガバナンスにはエージェントも含める必要がある
組織はすでに、従業員の入社、異動、退職に伴うアクセスを管理しています。ワークロードやエージェントにも、そのライフサイクルが従業員のものと一致しなくても、同等の統制が必要です。
組織は、各エージェントについて、次の実務的な問いに答えられるようにするべきです。
- 目的: なぜ存在し、誰がその利用を承認したのか。
- 責任: 誰が管理し、誰が業務上の目的に責任を負うのか。
- アクセス: どのシステムにアクセスでき、その権限は今も必要なのか。
- 認証情報: どのように認証し、認証情報はどのように保護されているのか。
- 監督: どの操作に承認が必要で、活動を調査できるのか。
- 廃止: 不要になったとき、誰が停止し、アクセスを削除できるのか。
これらはガバナンスの要件であり、すべてのアイデンティティ製品が自動的に提供する機能ではありません。エージェントを取り巻くアプリケーション、ワークフロー、運用プロセスに組み込む必要があります。
アイデンティティの次の段階
アイデンティティは、共有コンピューター上でユーザーを区別する仕組みから、人、デバイス、アプリケーション、自動化されたワークロードのアクセスを管理する仕組みへと広がってきました。AIエージェントは、それまでのすべてを置き換えるものではなく、この進化の次の段階です。
基本原則は変わりません。操作主体を認証し、権限を制限し、認証情報を保護し、活動を記録することです。委任された目標から、ユーザーが個別には指定していない操作が生じる可能性があるため、エージェントではこれらの原則がさらに重要になります。
適切なアクセス権限と明確な監督の仕組みを整え、組織が安心してエージェントを導入できるようにすることが重要です。